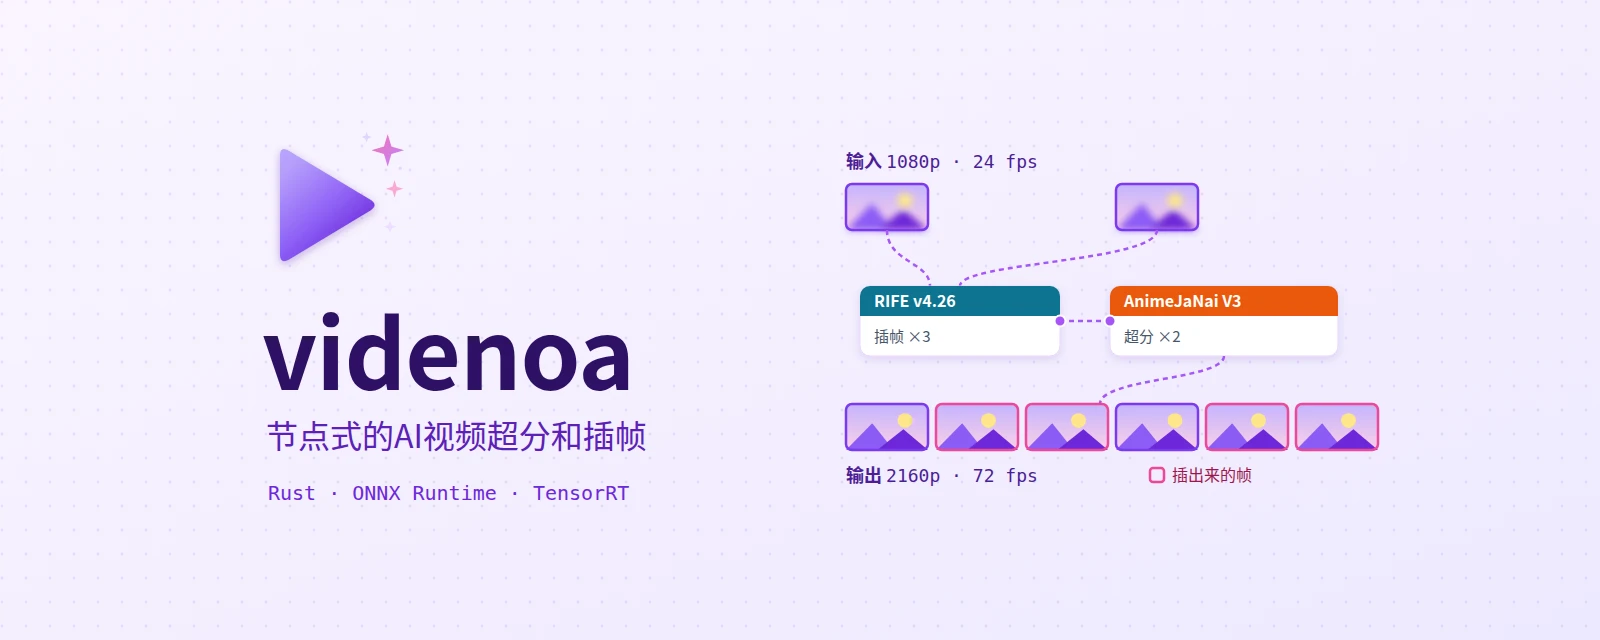

videnoa是自己做的一个AI视频增强工具,可以对视频进行超分辨率和插帧。处理的流程用节点图来描述,可以在网页上像搭积木一样把节点连起来,然后交给GPU去跑。代码发布在GitHub上,项目地址。
功能
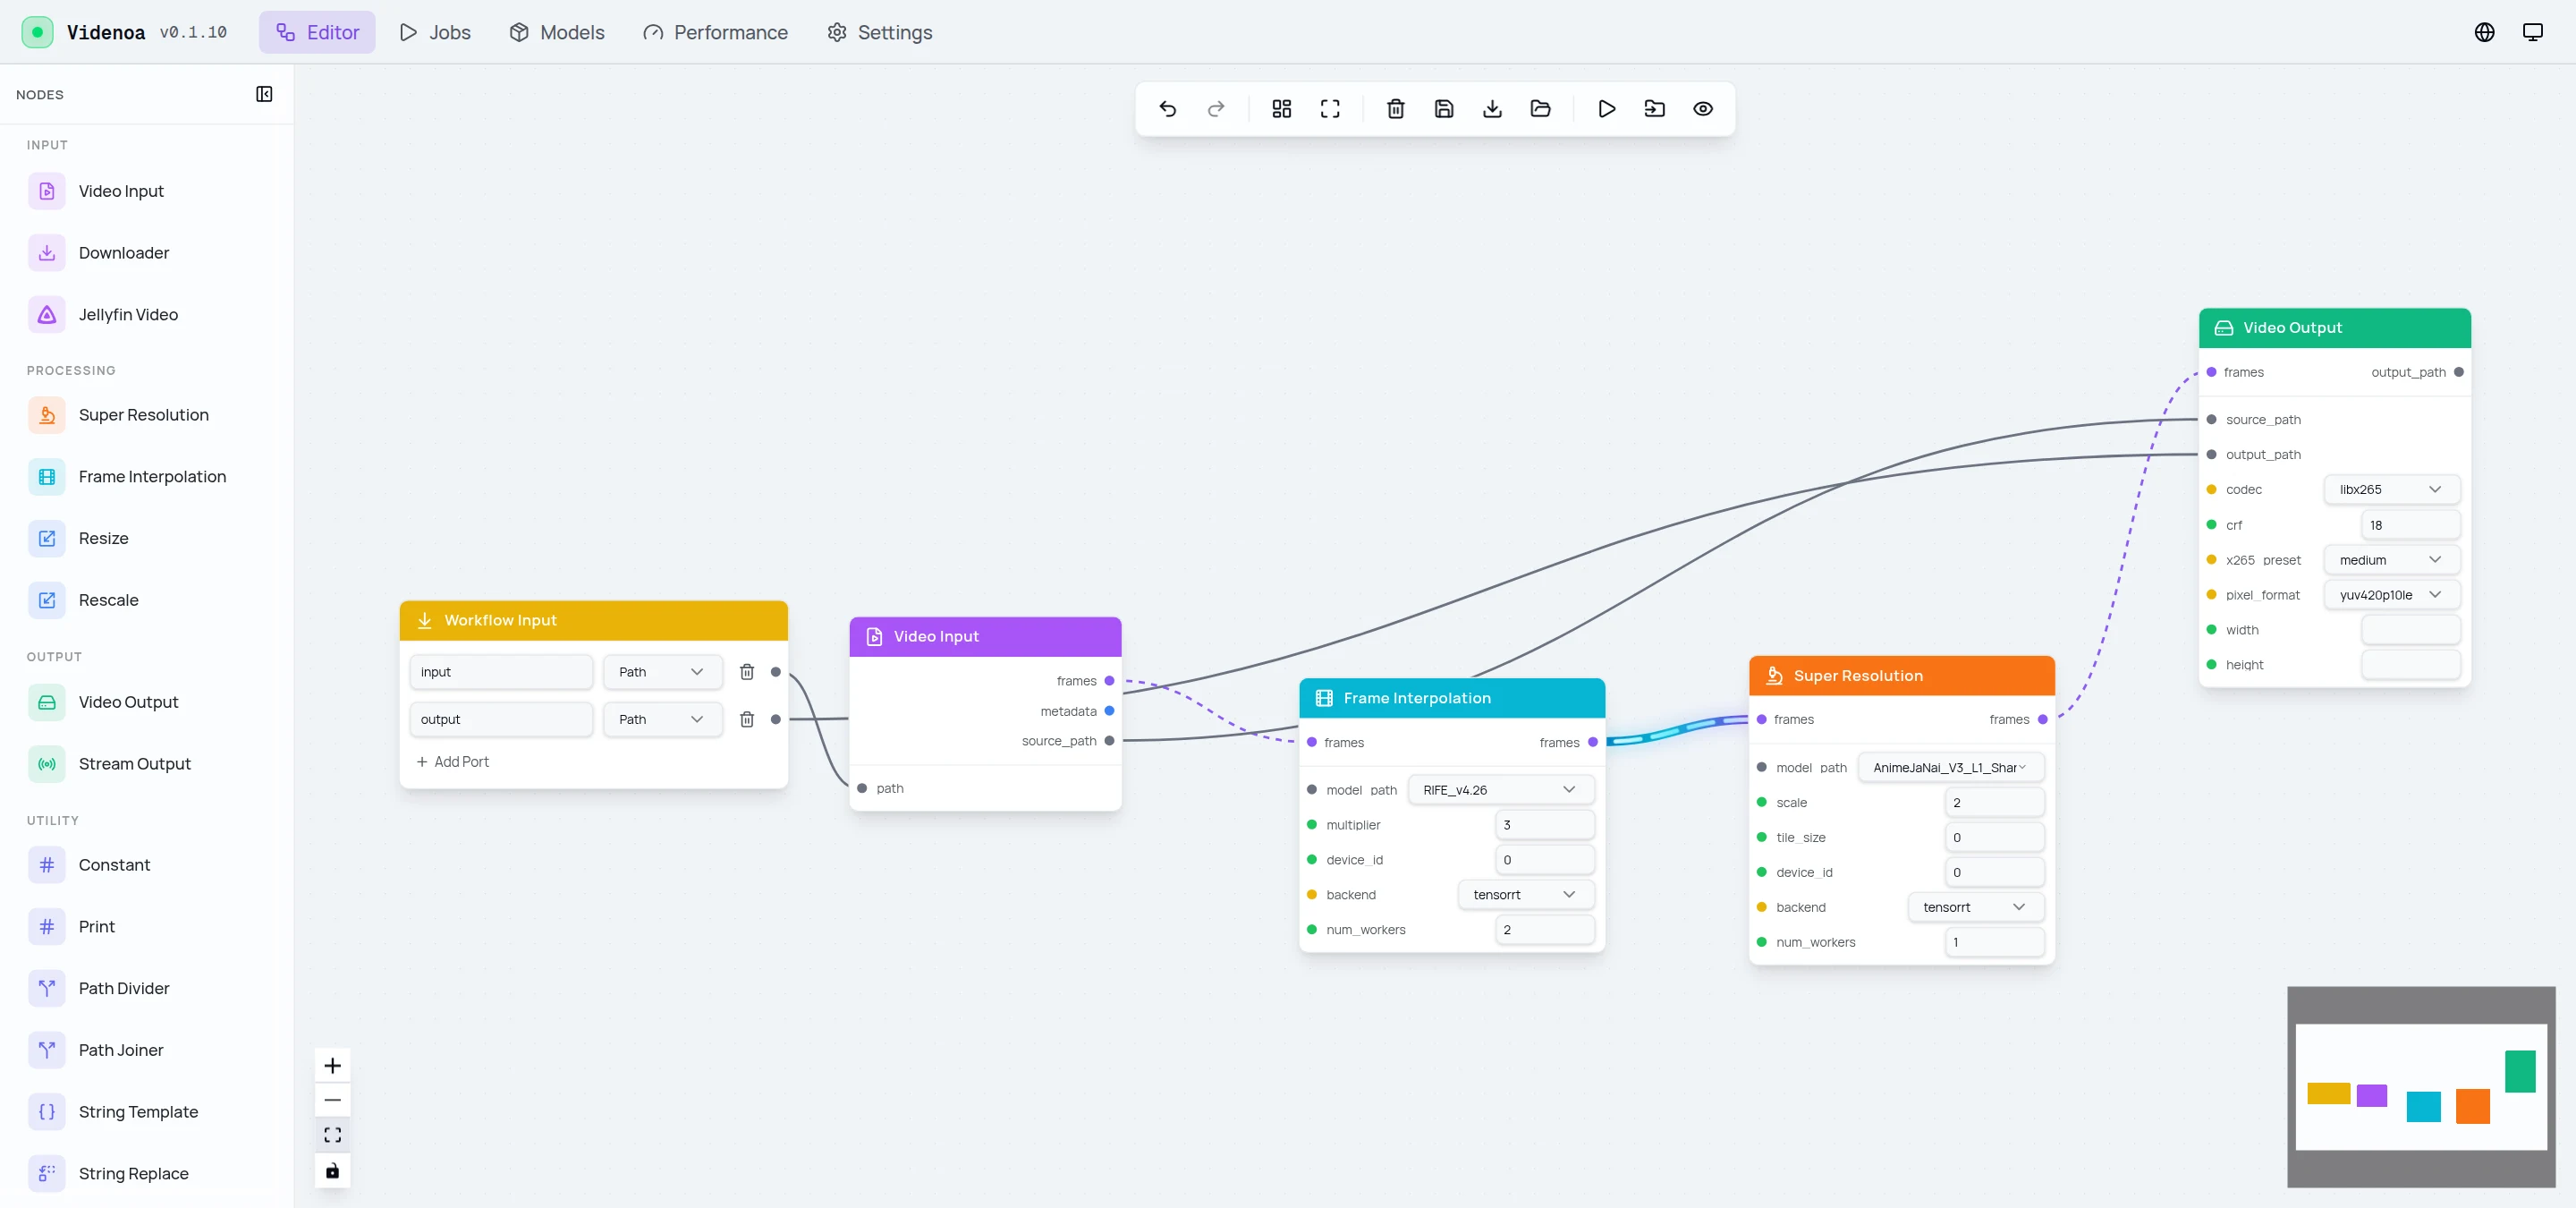
Fig. 1. Worker网页上的节点编辑器,图中是自己平时用的3倍插帧 + 2倍超分的预设
目前主要有以下功能:
- 超分辨率: 支持Real-ESRGAN[1],RealCUGAN[2]这一类的ONNX模型,比如动画用的AnimeJaNai[3],大的模型可以分块处理。
- 插帧: 使用RIFE[4] v4.26,可以插2倍、3倍或者更多。
- 推理: 通过ONNX Runtime[5]调用CUDA或者TensorRT[6],超分和插帧都可以开多个并行的推理通道。
- 节点编辑器: 网页上用React Flow[7]做的节点编辑器,除了视频输入输出、超分、插帧和缩放,还有Jellyfin、HTTP请求、下载、字符串和路径处理等节点。也可以先预览单帧的效果再提交。
- 多种入口: 同一个引擎可以通过命令行
videnoa run,网页服务和Tauri[8]的桌面版使用。 - 输出: 用FFmpeg[9]编码视频,支持x264,x265和NVENC。MKV输出会用mkvmerge[10]把原来的音频、字幕、章节和附件合进去。处理失败或者取消的时候不会留下不完整的文件。
- Controller: 一个不需要GPU的调度服务,可以跑在NAS上,把视频分发给一台或者多台GPU机器(Worker)处理,再把结果放回原视频的旁边。任务状态都保存在SQLite里,中途崩溃了也可以继续。
- 连接方式: Controller和Worker之间可以直接用HTTP(S),比如通过Tailscale,也可以用iroh点对点直连。
自己平时用的预设,是先用RIFE插3倍帧,再用AnimeJaNai V3做2倍超分,最后用x265编码。
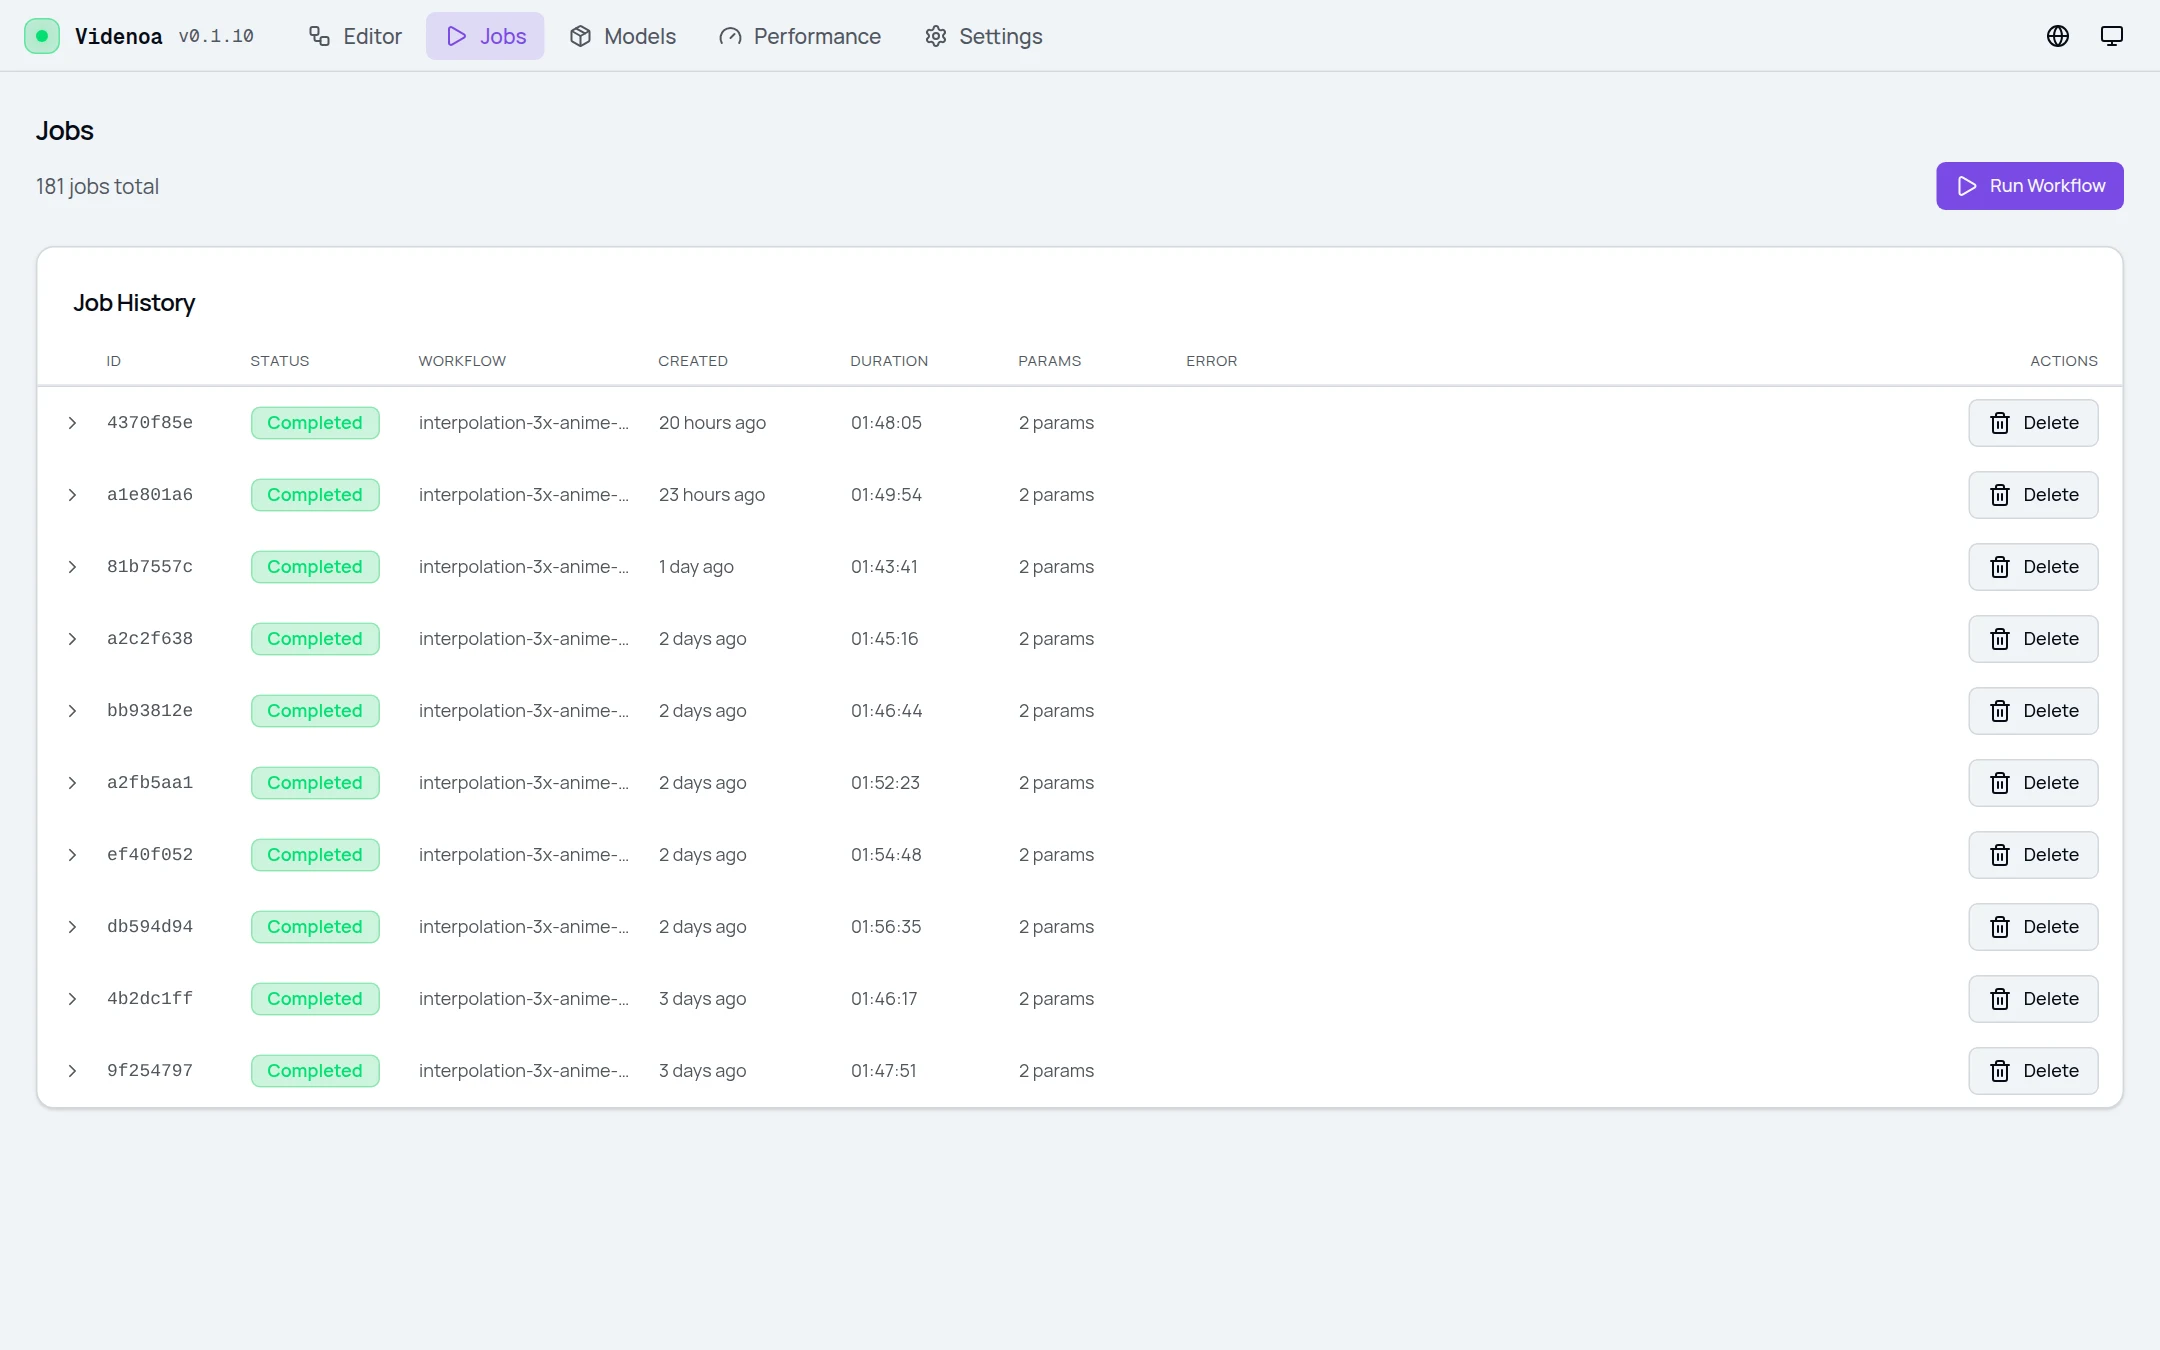
Fig. 2. Worker的任务列表,现在一集番剧大约需要1小时45分钟
使用方法
Worker需要NVIDIA的GPU,最简单的方法是用Docker:
1 | mkdir -p ./models ./trt_cache ./data |
然后打开http://<ip>:3000就可以用了。模型可以在GitHub Releases的misc里下载models.zip,解压到./models。第一次用TensorRT跑一个模型的时候,会先构建引擎,缓存到./trt_cache里,所以第一次会比较慢。
不想开网页的话,也可以直接用命令行跑一个预设:
1 | ./videnoa run presets/interpolation-3x-anime-2x.json --input input.mkv --output output.mkv |
Controller可以直接在NAS上用Docker跑:
1 | mkdir -p ./controller-data |
打开http://<ip>:3001,设置管理员密码,再把Worker添加进去。ANI-RSS这一类的工具,在下载完成之后调用Controller的POST /api/tasks就可以提交任务了。
Linux和Windows也有打包好的版本,可以在GitHub Releases里下载。如果要用iroh连接,需要先给Worker设置密码,在设置里打开iroh,再把Endpoint ID填到Controller里。
背景
自己的NAS上用ANI-RSS[11]订阅和下载新番,再用Jellyfin[12]来看。下载下来的番剧一般是1080p 24帧的,所以就想让新番下载完之后,可以自动地超分和插帧,再放回媒体库里。
做这个东西之前也考虑过用现成的工具,但是最后还是决定自己写,主要有两个原因。
第一个是自动化。这个系统要和自己的下载、媒体库对接起来,处理的流程也会经常调整。用节点的方式来描述流程,自由度更高,本身也有一定的编程能力,比如可以拼接路径、发HTTP请求、从Jellyfin获取视频,更符合自己对自动化脚本的需求。如果用不可视化的脚本来写,当然也可以实现,但是后续维护起来就没有那么容易了。
第二个是扩展。GPU计算的部分(Worker)是自己实现的,后续就可以往里面加任何想要的东西。比如后来加的Controller,可以在NAS上统一调度多台GPU机器,还可以用iroh[13]在不同的内网之间直连,这些东西做起来都挺有意思的。用现成的工具的话,这些就做不到了。而且现成的工具也没有告诉你,超分和插帧到底应该用什么样的技术栈来做。
当然,用现成的工具也有好处,就是不用自己去踩很多别人已经踩过的坑。比如后面会讲到的输出的MKV文件丢失音频的问题,就是自己最近遇到、然后专门花时间去修的。但是综合考虑,有一个自己能完全掌控的系统,还是要好很多。
名字videnoa是Video Enhancement Node-Orchestrated Automation的缩写,也就是用节点编排的视频增强自动化。
整体架构
Fig. 3. videnoa的整体架构
如上图所示,左边是NAS上的部分。ANI-RSS下载完新番之后,通过hook调用POST /api/tasks把任务提交给Controller。Controller挑一台空闲的Worker,把源视频上传过去,等处理完再把结果取回来,放到原视频的旁边,Jellyfin就会把它识别成同一集的另一个版本。Controller和Worker之间用HTTP(S)或者iroh都可以,这两种方式自己平时都会用。
右边是Worker。网页、桌面版和命令行用的是同一个引擎,节点图会先被编译成一条流式的管线: FFmpeg解码出原始的帧,经过插帧和超分之后,再交给FFmpeg编码。帧在各个节点之间通过有界的队列传递,不会写到硬盘上。最后如果输出是MKV,再用mkvmerge把原视频的音频、字幕等合回去。
后端是一个Rust的workspace,分成核心引擎、命令行、桌面版、Controller、iroh的传输层和Worker与Controller之间的协议几个crate。前端是React,Worker和Controller各有一个,都直接打包进Rust的二进制文件里。
性能优化
对这个系统来说,性能是最重要的。所以从一开始就定了一条规则: 每一次优化都要先做实验,和baseline对比,只有性能真的提升了才保留。实际做下来,大部分的优化在测试之后都没有保留下来,比如把FP16的输入直接借给ONNX Runtime,或者换成half::f16的数组,测出来反而更慢,最后都撤回了。
还有一点是数字要看清楚是在什么条件下测的。v0.1.1的时候,TensorRT在预热之后的稳定FPS提高了48%,但是算上启动和构建引擎这些时间,端到端只快了15.7%。
后来有用户反馈,在RTX 5080上跑的时候GPU利用率很低。查下来发现RIFE的ONNX模型把batch写死了,没法用更大的batch,多个线程共用一个session又会被锁串行化。最后的做法是开多个独立的TensorRT session,再用一个按顺序重排的缓冲区把帧排回原来的顺序。这样插帧快了大约1.55倍,后来又推广到了超分,也就是现在节点上的num_workers参数。再后面又加了按任务复用的帧缓冲池,超分 + 插帧的时间又少了38%。
Controller
Controller看起来只是把文件传过去,再传回来,但是大部分的工作其实都是在处理各种失败的情况。比如上传到一半断了、Worker处理完了但是回复丢了、下载回来的文件不完整、发布的时候目标已经有文件了等等。所以Controller里所有的任务状态都只以SQLite为准,提交任务是幂等的,失败的时候只重试失败的那一步,不会把已经跑完的AI处理再跑一遍,发布的时候也不会覆盖已有的文件。
这里也遇到过一个测试掩盖了问题的情况。在最后检查的时候,发现添加进去的Worker永远不会变成可用的状态,因为生产代码里根本没有定期检查Worker状态的循环。之前的测试都是直接把Worker的状态写成在线,所以一直没有发现。
踩过的坑
做视频处理,很多问题不会报错,只是结果不对。下面是遇到的一些比较典型的坑:
- TensorRT引擎缓存: 一开始所有模型共用一个缓存目录,结果1080p的RIFE引擎被拿去处理4K的输入。后来缓存改成按模型、输入尺寸和TensorRT、ONNX Runtime的版本来区分。
- 内存: Worker在空闲的时候占了16.9 GiB的内存,但实际在用的只有322 MiB,问题出在glibc的内存碎片。调用
malloc_trim之后降到了1 GiB左右,后来又加了帧缓冲池,减少反复申请内存。 - 退出时崩溃: 命令行跑完退出的时候,有时会报
corrupted double-linked list。原因是Rust这边的ort库在ONNX Runtime自己的C++静态析构函数执行完之后,才去释放全局的环境,最后的做法是让这个环境一直保留到进程结束。 - 颜色: RGB转YUV的时候用的是BT.601的矩阵,但是标记的却是BT.709,结果颜色会偏,比如纯绿色(0,200,0)播放出来是(0,167,0)。
- 亮度: FP32的RealESRGAN模型需要0到1的输入,但是实际传进去的是0到255,输出的画面亮度只有原来的一半。
- 音频: 有一次AI版本的视频播放时没有声音。原因是FFmpeg 7以后,在复制音频、而视频是从管道慢慢送进来的时候,会把音频全部排在视频的前面。最后改成FFmpeg只编码视频,再用mkvmerge把音频、字幕等合进去。
另外,第一个外部用户在Windows上用RTX 5090把720p的番剧处理到4K,一次就报了三个问题,包括Windows的路径、节点图的编译和Windows版FFmpeg没有x264和x265的编码器。这些都是自己的环境里不会遇到的。
AI开发
和oma-dotfile一样,这个项目的代码基本上也是agent写的。
一开始用的是OpenCode加上oh-my-opencode。最开始先和agent讨论整个系统怎么做,里面几个大的方向是自己定下来的:
- 后端用Rust而不是Python,性能更好,Docker镜像也不会太大。
- 只用ONNX模型,不考虑从PyTorch转换。
- 把处理流程做成类似ComfyUI那样的低代码节点,比如Resize节点、超分节点、插帧节点。
- 视频流以外的部分,比如音频、字幕,全部原样保留。
方向定下来之后,让规划的agent写成计划,再交给执行的agent一步一步做。agent有时候也会做得太多,比如一开始它加了批量处理和监控文件夹的功能,自己觉得是过度设计,就删掉了,Jellyfin做成一个节点,批量处理直接用bash循环就行。
大部分的代码是用GPT的模型写的,但是GPT写前端的能力比较弱,所以界面没有交给它来设计。第一版的界面是项目刚开始的时候用Claude Opus写的,Opus的前端能力也很强。后来重做Controller和Worker的界面时,是先用Claude Design出设计稿,再照着设计稿来实现,Controller的前端也有一部分是自己改的。
Controller也是先把需求写清楚: 部署在NAS上,和ANI-RSS、Jellyfin放在一起,通过HTTP(S)连接Worker,不需要SSH和网络挂载,也不做监控文件夹。然后让agent写成一个比较长的计划,按照TDD一个任务一个任务地实现,最后再有一轮独立的检查,前面说的Worker永远不可用的问题就是在这一轮被发现的。
后来主要用的是Claude Code。和oma-dotfile一样,会让Claude Code调用Codex,用GPT-6 Astra只读地检查整个项目,找出来的问题再由Claude对照代码确认之后修复。比如音频那个问题,第一次的修复就是在Codex的检查里发现还有遗漏,最后撤回重做的。后来Codex的额度快用完了,就改成用Claude自己的subagent来做设计的检查。
自己在这里面主要是决定要做什么,然后在agent改错的时候把它拉回来。比如:
- agent给Worker的任务历史加了数量上限,自动删除旧的记录。但是Controller要靠这些记录来查询任务状态,所以撤回了。
- agent打开了Dependabot,一下子开了好几个PR,自己把这些PR都关了,以后也不再开。
- agent把桌面版的数据目录换到了系统的应用数据文件夹,这样老用户的设置和工作流都会找不到,所以也撤回了。
现在的问题
现在用下来,还有两个比较大的问题,也是后面打算改进的地方。
- 速度: 现在还是太慢了,完全做不到实时。一集番剧做3倍插帧 + 2倍超分,也要将近两个小时。后续可能会考虑用DLSS这一类的技术来提高效率。
- Controller不够智能: 现在所有的任务都是由ANI-RSS的hook触发的,而ANI-RSS没法按条件决定哪些要处理、哪些不要。所以后续希望在Controller里加一个过滤的功能,比如本来就是4K的番剧就不用再超分了,本来就是60帧以上的也不用再插帧了。
总结
本文介绍了videnoa,一个用节点编排的AI视频超分和插帧工具。它用Rust写成,通过ONNX Runtime和TensorRT在GPU上推理,再加上一个跑在NAS上的Controller,把新番的下载、AI增强和媒体库串成了一个自动化的流程。
参考文献
- [1] X. Wang, L. Xie, C. Dong, and Y. Shan, "Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data," in ICCVW, 2021. https://github.com/xinntao/Real-ESRGAN
- [2] "bilibili/ailab (Real-CUGAN)", GitHub, 2026. https://github.com/bilibili/ailab
- [3] "the-database/mpv-AnimeJaNai", GitHub, 2026. https://github.com/the-database/mpv-AnimeJaNai
- [4] Z. Huang, T. Zhang, W. Heng, B. Shi, and S. Zhou, "Real-Time Intermediate Flow Estimation for Video Frame Interpolation," in ECCV, 2022. https://github.com/hzwer/Practical-RIFE
- [5] "microsoft/onnxruntime", GitHub, 2026. https://github.com/microsoft/onnxruntime
- [6] "NVIDIA/TensorRT", GitHub, 2026. https://github.com/NVIDIA/TensorRT
- [7] "xyflow/xyflow (React Flow)", GitHub, 2026. https://github.com/xyflow/xyflow
- [8] "tauri-apps/tauri", GitHub, 2026. https://github.com/tauri-apps/tauri
- [9] "FFmpeg", FFmpeg, 2026. https://ffmpeg.org/
- [10] "MKVToolNix", MKVToolNix, 2026. https://mkvtoolnix.download/
- [11] "wushuo894/ani-rss", GitHub, 2026. https://github.com/wushuo894/ani-rss
- [12] "jellyfin/jellyfin", GitHub, 2026. https://github.com/jellyfin/jellyfin
- [13] "n0-computer/iroh", GitHub, 2026. https://github.com/n0-computer/iroh