
bili-parser是一个用来解析B站视频信息的网页工具,输入B站链接之后,可以得到视频的封面、标题、播放数据和简介,并且一键复制成方便分享的格式。后来又加上了基于Whisper的AI字幕,以及基于字幕的AI摘要和对话。代码发布在GitHub上,项目地址,在线版本部署在Vercel上。
背景
之前在QQ群里看到有一个bot,别人在群里发了B站链接之后,它会自动回复这个视频的信息和总结,个人觉得这个功能挺好的。
但是如果是自己手动把B站链接转发给别人,就会有一个问题。对方只能看到一个链接,并不知道这个视频里面包含什么内容,得点进去才能看,所以吸引力就不是很强。如果转发的时候能带上封面、标题、播放数和简介,吸引力就会强很多。
所以就先做了这个工具,把视频的metadata整理成一段可以直接复制的内容,然后再慢慢往上加功能。
功能
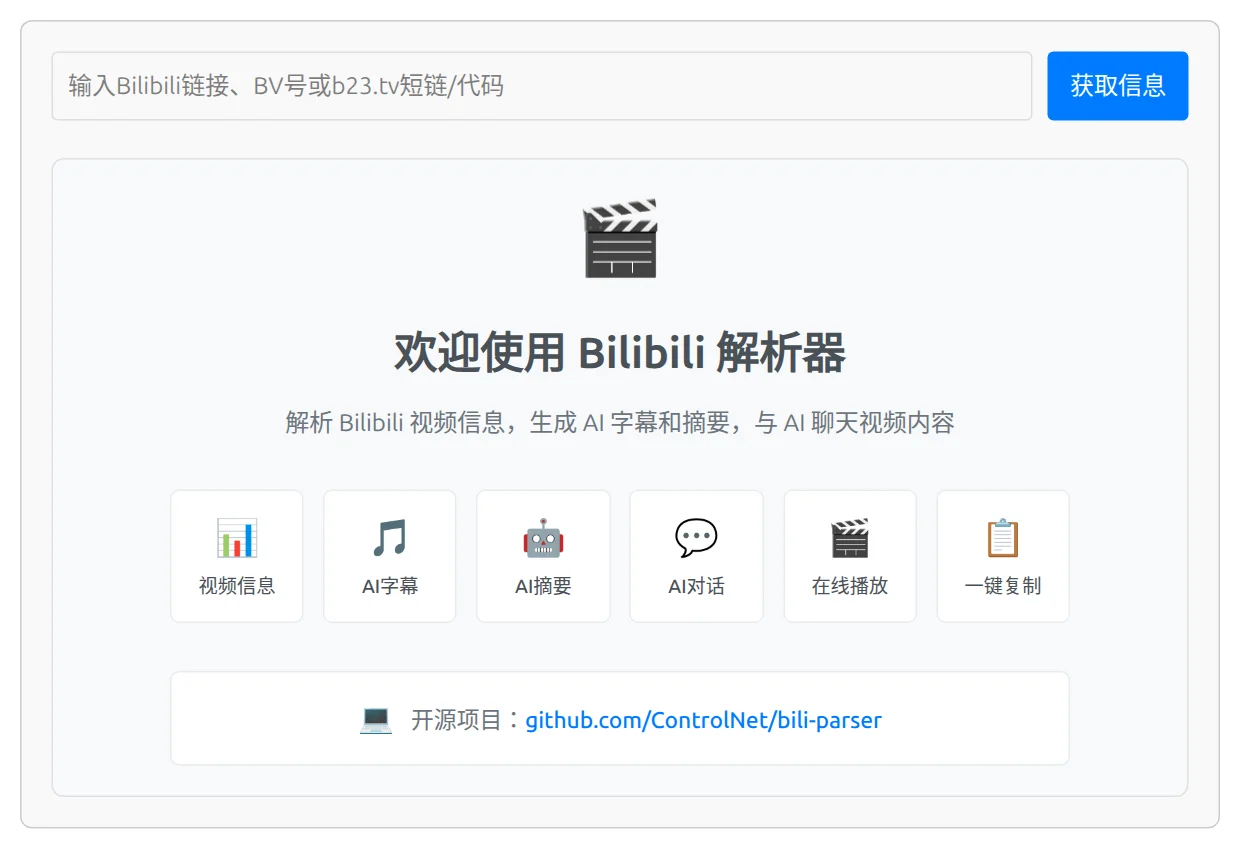
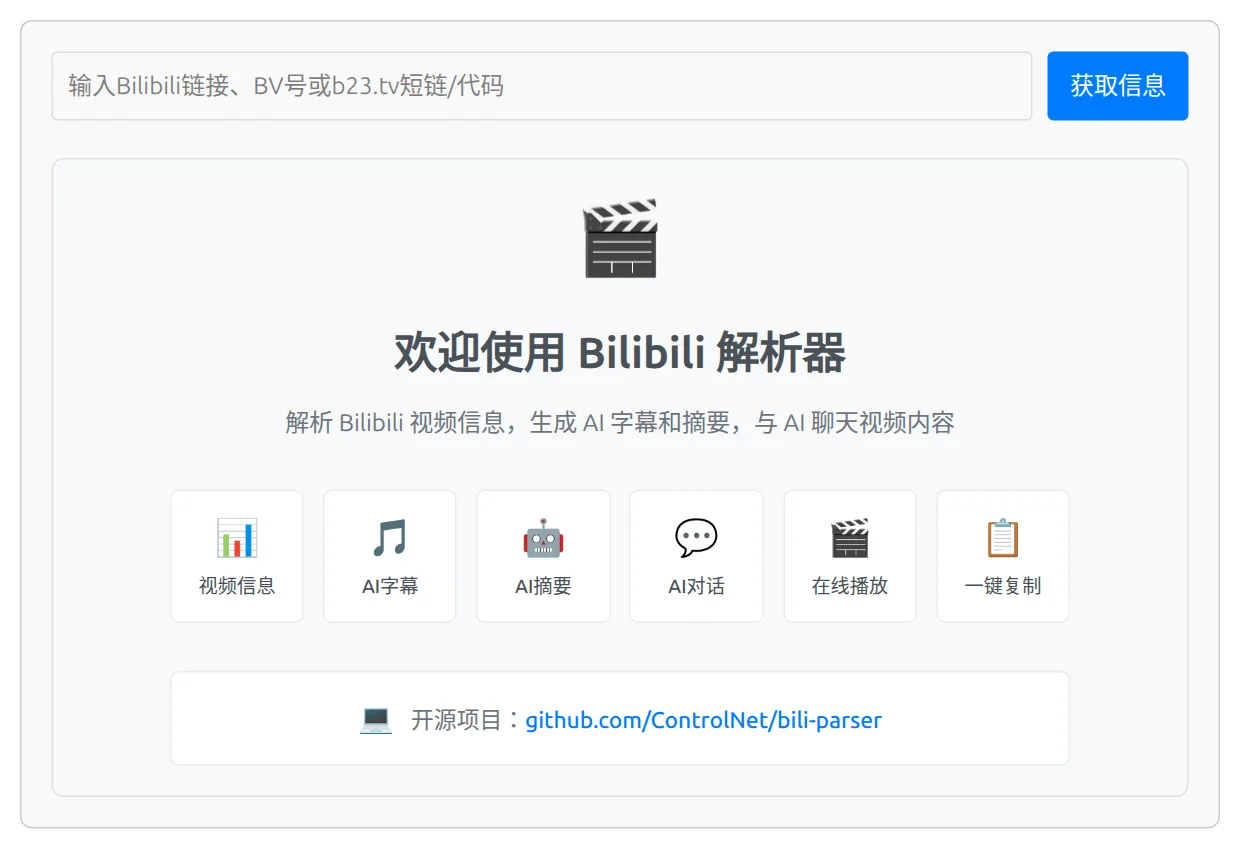
Fig. 1. bili-parser的首页
目前主要有以下功能:
- 视频信息: 输入可以是完整的B站链接、带有其他文字的分享文本、BV号,或者b23.tv的短链和短链代码。解析之后会显示封面、标题、UP主和粉丝数、播放/弹幕/点赞/投币/收藏/分享数据、简介,以及当前在线观看的人数。
- 在线播放: 页面里嵌入了B站的播放器,可以直接看视频。
- 一键复制: 把上面的信息复制到剪贴板,同时包含纯文本和带封面图的富文本,粘贴到支持富文本的地方就会带上封面。
- AI字幕: 通过自己部署的Whisper服务生成带时间戳的字幕。
- AI摘要和AI对话: 基于视频信息和字幕,用大模型生成摘要,或者针对视频内容进行对话。
每个视频也有自己的页面,比如 https://bili-parser.vercel.app/BV1xx411c7mD,可以直接把这个地址发给别人。
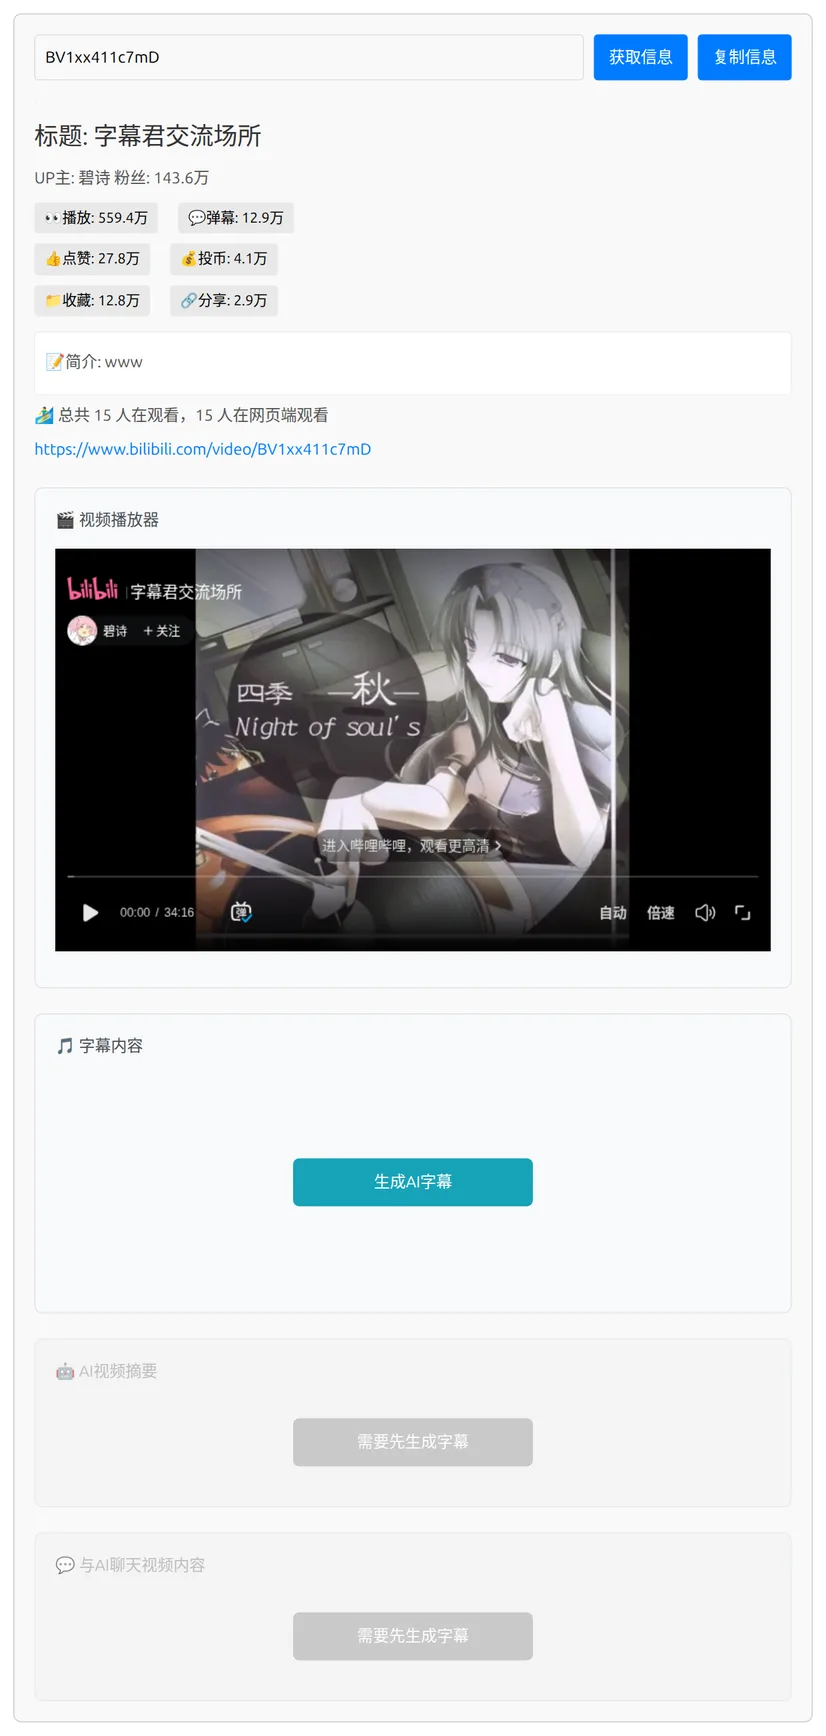
Fig. 2. 解析B站最早的视频字幕君交流场所(BV1xx411c7mD)的结果
复制出来的纯文本是这样的,粘贴到聊天软件里面基本上一眼就能看到这个视频是什么。
1 | 标题: 字幕君交流场所 |
使用方法
在线使用
直接打开 https://bili-parser.vercel.app,粘贴链接之后点获取信息,然后点复制信息就可以了。
API
除了网页之外,也提供了两个API,方便在别的地方调用。
/api/parse: 返回JSON格式的视频信息/api/copy: 返回和网页上复制的内容一样的纯文本
1 | curl "https://bili-parser.vercel.app/api/parse?url=BV1xx411c7mD" |
其中url参数可以是BV号,也可以是URL编码之后的完整链接。
自己部署
1 | git clone https://github.com/ControlNet/bili-parser.git |
然后访问 http://localhost:5173 就可以了。.env 里面有以下几个变量:
WHISPER_ASR_URL: Whisper服务的地址,用于生成AI字幕OPENAI_API_KEY,ANTHROPIC_API_KEY,GOOGLE_GENERATIVE_AI_API_KEY: 用于AI摘要和对话,至少配置一个,按照这个顺序使用第一个配置了的
如果只用视频信息和复制功能,不需要配置任何环境变量。
Whisper服务需要部署在有GPU的机器上,可以直接用打包好的docker镜像。
1 | docker run -d --gpus all -p 9000:9000 --name whisper \ |
实现
整个项目使用SvelteKit[1] + Tailwind CSS,部署在Vercel上。由于浏览器直接请求B站的API会遇到跨域的问题,所以对B站的请求都是通过SvelteKit的服务端接口转发的。
视频信息
第一个版本是一天之内做完的。输出视频的metadata还是比较容易的,B站有现成的接口可以拿到视频信息、UP主的粉丝数和在线人数,整理成固定的格式就行。b23.tv的短链则是在服务端请求一次短链,不跟随跳转,从返回的Location里读出真正的视频地址。
比较麻烦的是封面图。B站的图片有防盗链,所以又加了一个图片代理的接口,带上B站的Referer去获取封面。复制富文本的时候,封面会转成base64直接嵌入到HTML里,如果图片超过5MB,就按0.8倍一步一步缩小,直到小于5MB为止。
AI字幕和对话
做完基本功能之后,又想要能基于视频的内容进行对话,所以首先需要获取视频的全部字幕。但是结果发现,B站的字幕没法匿名获取,必须要登录账号,这样可能会造成一些别的问题。
所以换了一个思路,自己部署一个Whisper[2]服务来识别视频里的语音。具体的流程是,bili-parser先通过B站的接口拿到视频的音频流地址,然后发给Whisper服务,Whisper服务下载音频之后识别出所有的transcript。这里fork了whisper-asr-webservice[3],做了以下几个修改:
- 音频地址: 支持直接传入
audio_url,由服务端自己下载音频 - 异步任务: 用
/submit提交任务,然后用/get/{job_id}查询结果,网页端每10秒轮询一次 - 缓存: 用
bili_{bvid}_{cid}作为音频的id,识别结果存到SQLite里,同一个视频不需要重复识别
改完之后打包成了docker镜像controlnet/whisper-api。一开始字幕接口是同步请求的,同一天晚上就改成了异步提交加轮询,然后又加上了缓存。另外Whisper识别出来的中文经常是繁体,所以还要再转成简体。
有了字幕之后,把视频的背景信息和字幕一起作为上下文交给大模型,就可以生成摘要和进行对话了。大模型的部分用的是Vercel AI SDK[4],支持OpenAI,Anthropic和Google三家。自己用的是Google的免费API,摘要用的是Gemma 3,对话用的是Gemini 2.0 Flash。
Windows和iOS
有了这些功能之后,除了在网页上点击使用,也希望在别的地方能方便地使用。
首先是Windows。在Windows上,没有办法简单地通过某个API把带封面的内容自动复制到剪贴板,如果要用API,怎么说也得套个壳。所以就写了一个本地的Python脚本,直接对Windows的剪贴板进行写入。这个脚本完全重现了网页端复制的逻辑,但是并没有基于bili-parser的API来写。
然后是移动设备。iOS上用的是快捷指令,请求bili-parser服务端的API,获取视频的相关信息然后复制。但是这样只能复制文本,没有办法把封面图一起复制,对分享来说还是有一些限制。
412风控
2026年9月的时候,发现B站的API会返回412,也就是被风控了。之前为了模仿浏览器,服务端在请求时手动加了一个Chrome 91的User-Agent和Referer等header,最后的修复反而是把这些伪造的header全部删掉,直接请求就恢复正常了。
现在的问题
用了一段时间之后,发现这里面还是有一些问题,可以作为后续改进的部分。
- 字幕获取: 应该有更好的办法去获取字幕,通过Whisper去识别,总归来说是不太靠谱的。
- 缺少视觉信息: 现在的对话完全是基于语音识别出来的文字,失去了所有的视觉能力,不能完整地反映视频的情况。
- ASR服务: 现在依赖自己的本地服务器来跑Whisper,但是实际上像Cloudflare[5]这样的平台都有免费档的语音识别服务,没有必要自己去搭服务器。而且现在也没有支持OpenAI兼容的语音API。
- Windows脚本: 可以直接重用bili-parser服务端的API,本地只负责和剪贴板交互,甚至用PowerShell就够了,不需要Python。
- iOS快捷指令: 只能复制文本,封面图的部分还需要想办法解决。
总结
本文介绍了bili-parser,一个解析B站视频信息、方便分享B站链接的小工具,以及后来加上的AI字幕、摘要和对话功能。目前视频信息和复制的部分已经可以满足日常使用,AI和多端的部分还有不少可以改进的地方,以后有空再继续做。
参考文献
- [1] "SvelteKit • Web development, streamlined", Svelte, 2025. https://svelte.dev/docs/kit
- [2] A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever, “Robust Speech Recognition via Large-Scale Weak Supervision,” in Proceedings of the 40th International Conference on Machine Learning (ICML), 2023, pp. 28492–28518.
- [3] "ahmetoner/whisper-asr-webservice", GitHub, 2025. https://github.com/ahmetoner/whisper-asr-webservice
- [4] "AI SDK", Vercel, 2025. https://ai-sdk.dev/
- [5] "Workers AI", Cloudflare, 2025. https://developers.cloudflare.com/workers-ai/